新品发布
盒子只是外壳,你真正在选的是里面那张卡。
产线、家庭、设备、机器人、多路相机汇聚点用的小脑。一张 RK1828 装 3B,两张装 9B,四张装 27B —— 机箱、固件、工具链都不变,模型容量从一个采购决定变成一个卡数决定。
2026-10-30·新品发布·深圳
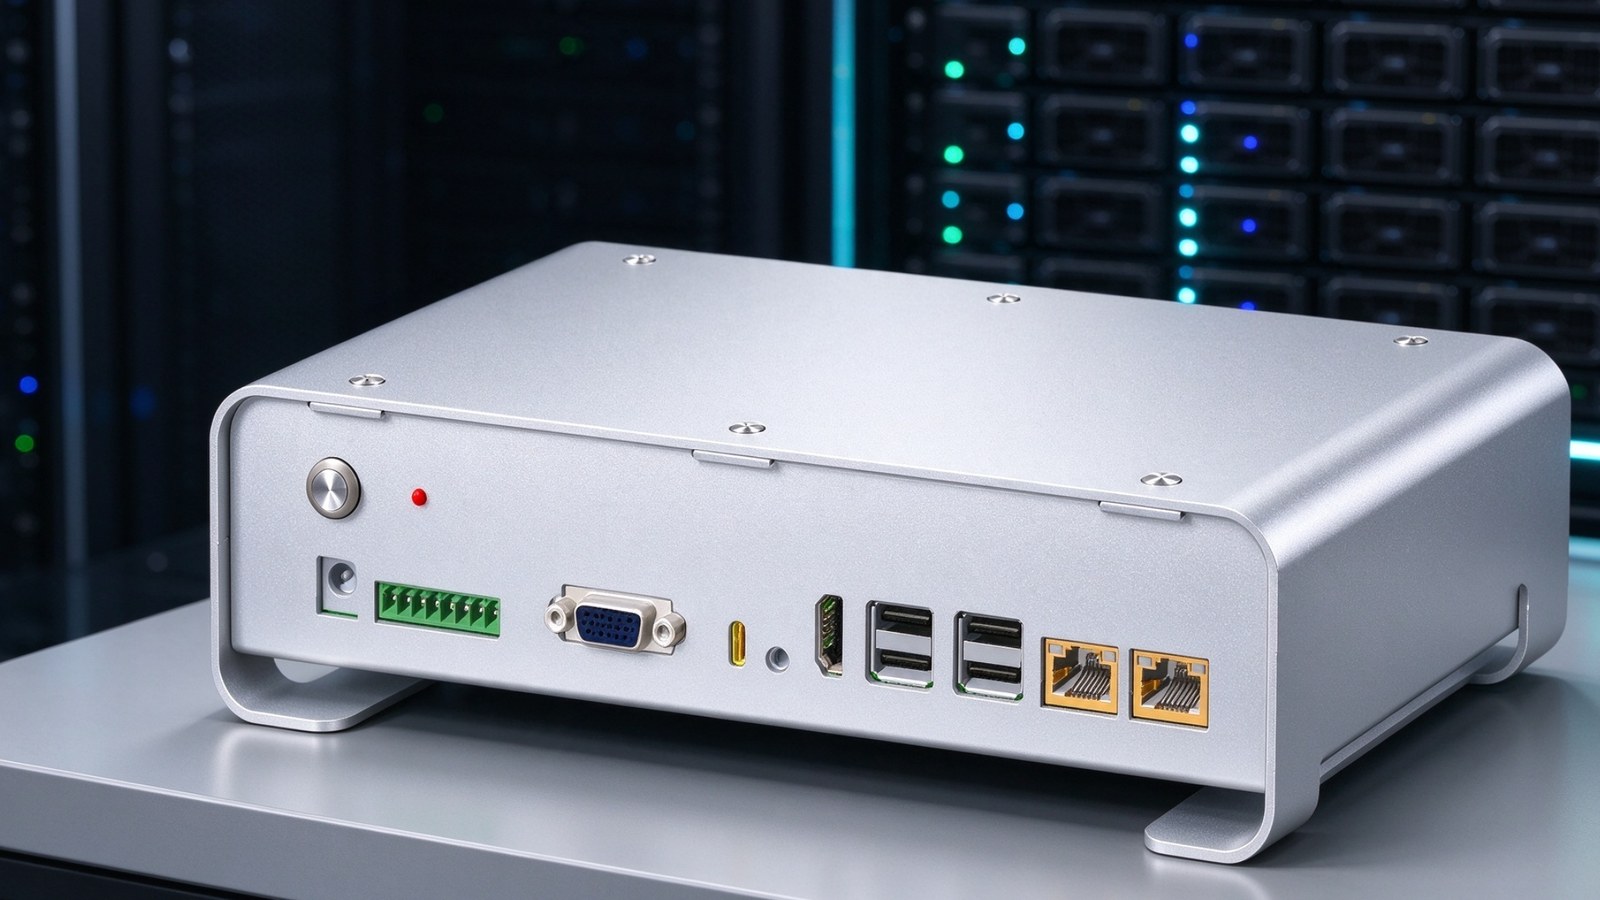
有一类地方,模型必须跑在那里,而服务器去不了:产线有电但没有机柜;家里有路由器但没有风道;设备腔体只剩 40mm 净空,现场也没有人守着能随时重启。这台盒子就是为这些地方做的,它在那儿干的活在工厂里有个朴素的名字 —— 小脑,就地判断,而不是事事上云。
真正值得讨论的设计决定不是外壳,而是把模型容量放在一张可替换的卡上,而不是压在主控里。一张 RK1828 装下 3B 级模型,两张装 9B,四张装 27B。机箱、固件、部署工具都不变,变的只是里面插了几张卡。客户先用 3B 做检测,后来要做整线推理要上 27B,不需要再买第二台盒子。
两个主控可选。RK3576 带一张卡,负责产线侧那摊事:检测、作业指导、本地语音助手。RK3588 带一张或四张,四卡的配置才装得下 27B 模型常驻。
同一套硬件会出现在四个位置、顶着三个名字,而这个名字不是包装,它在说:这台盒子是设备上唯一的计算机,还是坐在更大一台后面的那一台。
| 角色 | 装在哪 | 凭什么 |
|---|---|---|
| 小脑 — 边缘网关 | 产线、家庭、设备腔体 | 就地判断,画面不出厂,答案不等一个来回 |
| 小脑 — 视觉融合与视频分析 | 多路相机的汇聚点 | RK1828 扛模型,KA08 扛密集解码与传统 CV,最高 32 路 1080p |
| 大脑 — 机器人与机器狗 | 机体内部 | 四卡 27B 配置均值 57.8W。这个数就是拿去和平台功耗与散热预算对的那一个,也正是它不是机架产品的原因 |
| 场景化智算服务器 | 每条线、每个房间一台现场节点 | 两卡均值 30.5W、四卡 57.8W — 普通机柜放得下,不必为此建一间机房 |
“脑”这个字在表里是有分量的。在机器狗身上,这台盒子是唯一在思考的东西,所以它是大脑。在产线上,PLC、MES 和一个负责人已经在位,所以它是小脑 — 它只接管需要模型的那部分,不去开产线。这条边界划错,边缘 AI 项目就会变成跟控制系统抢方向盘,而不是帮它。
决定模型容量的东西比 TOPS 朴素得多:卡上挂了多大权重的内存。RK1828 封装内带 5GB 三维堆叠 DRAM,RK1820 是 2.5GB。真正决定一个模型是稳态跑还是每个 token 都要把权重重新搬过总线,是这个数,不是旁边那个 20 TOPS。
| 配置 | 模型级别 | 怎么切 | 依据 |
|---|---|---|---|
| 1 × RK1828 | 3B — LLM、VLM 或稀疏 MoE | 整模型单卡常驻 | 产品定义 |
| 2 × RK1828 | 9B — 如 Qwen3.5-9B | 32 个 Decoder 层切两段:0–18 层在卡 0,19–31 层加 final norm 与 LM Head 在卡 1 | 瑞芯微级联方案 2026.08 |
| 4 × RK1828 | 27B — 如 Qwen3.8-27B | 四段顺序执行,中间特征逐卡传递 | 瑞芯微级联方案 2026.08 |
切分是按 Decoder 层,不是按张量,所以它能扩到四张卡而不用重写代码。主机负责分词、调度各段、采样;每张卡只跑自己那一段,把隐状态交给下一张。
瑞芯微公开了两卡与四卡配置的实测数据。条件是 RK3588 主机、RK1828 SO-DIMM 模组、W4A16 量化、4K 或 8K 输入、128 输出 token,都是整机口径:
| 模型 | 卡数 | 输入 | 接口 | TTFT | Prefill TPS | Decode TPS |
|---|---|---|---|---|---|---|
| Qwen3.5-9B | 2 | 4K | PCIe | 4.80 s | 853.7 | 33.19 |
| Qwen3.5-9B | 2 | 4K | USB 3.0 | 4.90 s | 836.0 | 33.52 |
| Qwen3.5-9B | 2 | 8K | PCIe | 9.73 s | 841.7 | 32.33 |
| Qwen3.5-9B | 2 | 8K | USB 3.0 | 9.94 s | 824.0 | 32.65 |
| Qwen3.8-27B | 4 | 4K | PCIe | 6.92 s | 592.1 | 13.02 |
| Qwen3.8-27B | 4 | 4K | USB 3.0 | 7.15 s | 573.2 | 13.02 |
| Qwen3.8-27B | 4 | 8K | PCIe | 13.67 s | 599.4 | 12.74 |
| Qwen3.8-27B | 4 | 8K | USB 3.0 | 14.08 s | 581.7 | 12.83 |
上下两块要分开读,它们说的不是一件事。两卡跑 9B,解码 33 token/秒 — 比人读书快,够一个人在等的时候把问题问完。四卡跑 27B,解码 13 token/秒 — 不是聊天速度,但读一份报告绰绰有余,这正是整线推理和文档类工作的合理目标。模型翻了三倍,解码时间大约是 2.5 倍,这笔账就摊开在这里。
另一条轴是输入长度。输入从 4K 到 8K,TTFT 差不多翻倍,解码几乎不动 — 因为 prefill 与提示词长度成正比,而 decode 只与模型本身有关。提示词是长文档,等待时间要留在开头;是短问答,输入长度基本无所谓。
让一颗 SoC 同时扛媒体管线和语言模型,两边都会输,而且是排不掉的那种输:模型要和解码器、ISP、显示通路抢同一份 LPDDR,延迟不再是一个你能设计出来的数字。
两边的链路故意做得很窄:PCIe 2.0 ×1,或 USB 3.0。够用的唯一原因是权重根本不过这条线 — 加载一次就常驻在卡自己的堆叠 DRAM 里,过线的是提示词和一串 token。
这个结论是可测的,也正是这套架构值这个 BOM 成本的原因。9B 模型在两卡上跑的时候,主机 CPU 占用 2.4 %(以 4 核 A76 满载为 100 % 计),主机内存均值 179MB、峰值 310MB。27B 四卡时是 2.6 % 和 191MB,峰值 524MB。
| 配置 | 卡数 | 接口 | 主机 CPU | 内存均值 | 内存峰值 | 整机功耗均值 | 整机功耗峰值 |
|---|---|---|---|---|---|---|---|
| Qwen3.5-9B | 2 | PCIe | 2.4 % | 179 MB | 310 MB | 30.5 W | 67 W |
| Qwen3.5-9B | 2 | USB 3.0 | 2.0 % | 181 MB | 312 MB | — | — |
| Qwen3.8-27B | 4 | PCIe | 2.6 % | 191 MB | 524 MB | 57.8 W | 119 W |
| Qwen3.8-27B | 4 | USB 3.0 | 2.2 % | 187 MB | 523 MB | — | — |
功耗是整机验证值,包含 RK3588 主机、四组 SO-DIMM 和算力卡散热风扇。四卡 27B 的 均值 57.8W、峰值 119W 才是决定这台盒子能不能放进没有空调的机柜的数字 — 大约是一台办公小主机的功耗,不是 GPU 服务器的。
“小脑”这个词在工程上的意思就是这个:主控继续干它原本的活 — 抓图、解视频、跑现场总线、执行业务逻辑 — 不会因为接了个模型而变慢。盒子上其他所有的东西,都不需要和模型抢资源。
产线上有两类活,方向正好相反。
品质检测要的是确定性。检测模型盯着运动中的工件,截止时间以几十毫秒计,错过一次就是一件废品或者一次停机。它不能排在语言模型后面。
作业指导要的是覆盖面。告诉操作工下一步做什么、回答“这件为什么被判废”、读一张图纸并指出关键的那个尺寸 — 这是视觉语言模型的活,它容忍一秒延迟,换来的是能解释自己。
把这两件放在同一张卡上,它们就得轮流用,而先断的一定是检测的截止时间。分卡在结构上就解决了:卡 0 跑检测,卡 1–3 挂语言模型。这就是要买比模型本身所需更多卡的实际理由,也是产线已经在跑、受不了卡顿时的推荐配置。
单卡盒子上这个分工也能做,但靠的是调度而不是隔离。真到了报价的时候,我们会把这一点说清楚。
一台只做推理的边缘盒子是成本;一台还能把现场证据带回来的边缘盒子是投资,差别就是一个方向的流量。
盒子看得到产线真正产出的画面,包括模型判错的那部分。而只有这部分画面值得标。闭环长这样:盒子给自己的输出打分,留下低置信度的和操作工推翻过的,连同上下文一起上传;标注、重训、重新量化;新权重下发回同一批卡。硬件一点没变,变的只是卡上的文件。
这一点我们不含糊:闭环是我们交付的一项服务 — 采集策略、标注、训练、再部署回设备 — 不是盒子自带的能力。宣称自己能训练的硬件,多数是一个会传图片的脚本。
硬件真正贡献的是让这个闭环变便宜的理由:因为容量在卡上,“换模型”是换卡上的文件,“新模型要更多内存”是改卡的数量,而不是换一台机器。
每张卡要一条 PCIe 2.0 通道,或一个 USB 3.0 口。这些口怎么来,决定了一台盒子是两卡还是四卡。
每张卡独占一条 PCIe 2.0 ×1。最简单也最快,主机通道有余量时首选。
一条上行链路 — PCIe 2.0 ×1 或 PCIe 3.0 ×4 — 扇出到四张卡。省主机通道,也是让主机挂得动四卡的原因。
四张卡共用一个 USB 3.0 HUB。做出四卡样机最快的路子,主机 PCIe 已经被相机或存储占走时也该选它。
同模型同卡数下 PCIe 与 USB 3.0 的实测差距:TTFT 与 prefill 约 2–3 %,解码上基本没有差别。差距就这么大 — 大到在延迟敏感的产线上该指定 PCIe,小到不该拦着任何人先用 USB 做样机。
主机这一侧,RK3588 之所以是四卡平台,原因就在规格表里一行:PCIe 3.0 ×4 可拆分为 1×4、2×2 或 4×1,另有两条 PCIe 2.1 ×1 走共用 combo PHY。四张单通道卡是这一个控制器的受支持配置,不是技巧。RK3576 提供两组 combo USB 3.0 / PCIe 2.1 / SATA3,所以它的配置是单卡。
负载是大模型、软件栈是瑞芯微 RKNN 工具链时,RK1828 是对的卡。但如果客户带着一套能跑的 CUDA 代码和一个调了三年的视频分析管线找过来,它就是错的卡 — 把那些搬到一个新工具链上是一个项目,而项目有它自己的脾气,经常做不完。
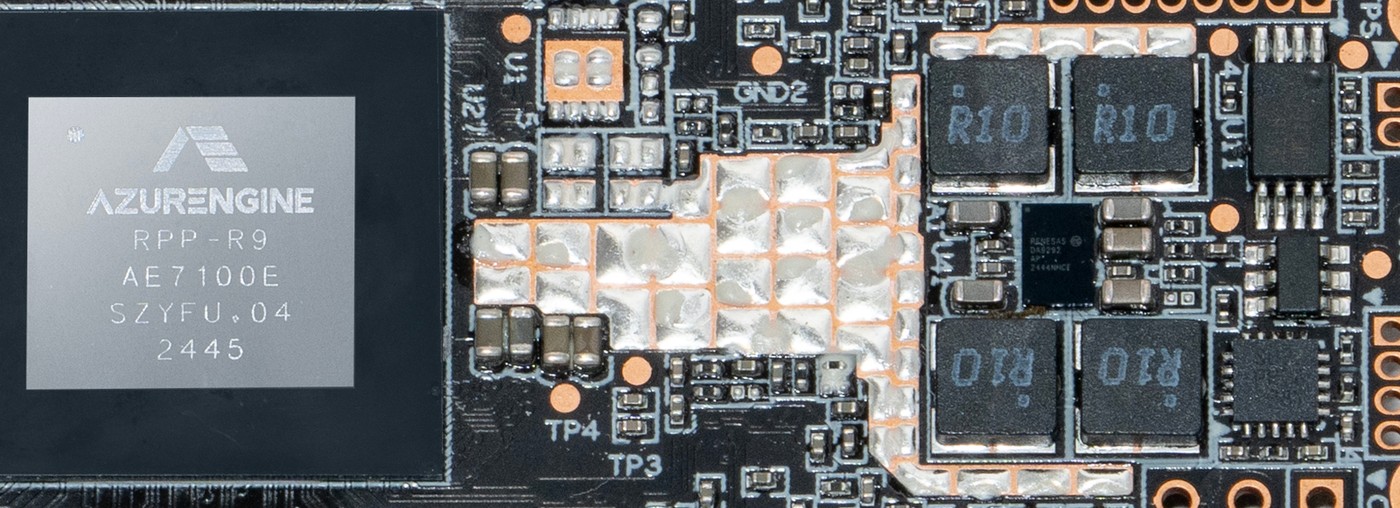
对这类客户,RK3588 盒子可以改插一张 KA08 通用 GPU 卡。它搭载芯动力 RPP-R8:32 TOPS INT8、16 TFLOPS BF16/FP16、1024 个 ALU 与 8092 个 MAC16、24MB 片上共享存储(约 1TB/s)、四组 32 位 LPDDR4/LPDDR4X 合计约 59.7GB/s,主机接口 PCIe Gen3 ×4,模块尺寸 80 × 22 mm。
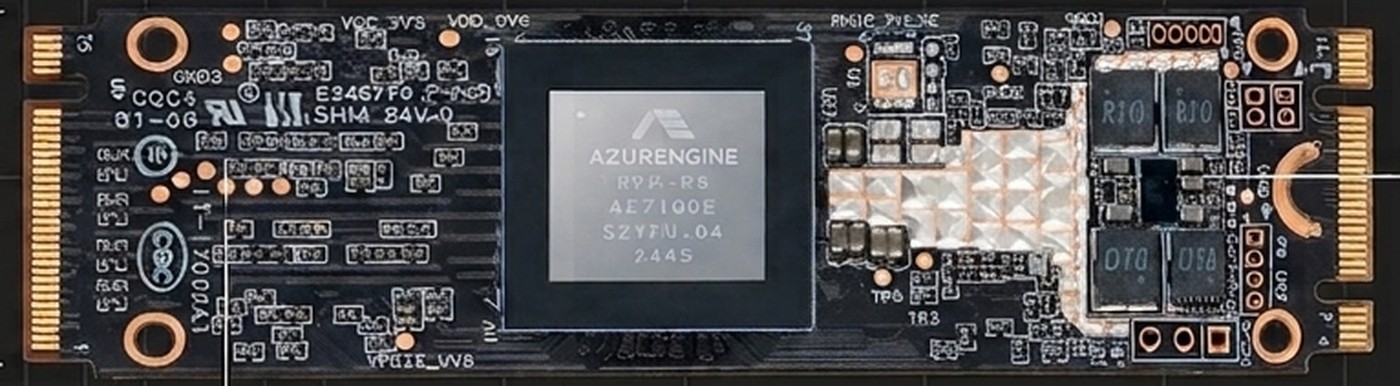
这张卡出现在这一页,全部理由是两个字:CUDA。RPP-R8 在软件上兼容 CUDA 与 TensorRT,已有的推理栈搬过来是移植,不是重写。它还带四路硬件 H.264/H.265 解码引擎,最高 32 路 1080p@30 — 这是视频分析的数字,不是语言模型的数字,而它本来也是为那类负载准备的。
两张卡的分工因此很干净。RK1828:大语言与视觉语言模型、RKNN 工具链、靠卡数从 3B 走到 27B。KA08:存量 CUDA 与 TensorRT 负载、传统计算机视觉、密集视频解码,单卡 32 TOPS。四卡 RK3588 盒子两种都能量,我们会告诉你你的负载到底要哪一种,而不是我们更想卖哪一种。
供货。KA08 接受预定,1 月交期,10 台起订。RK1828 配置按单报价。
盒子里装了个模型,不等于系统上线了。这两者之间隔着量化方案、上下文预算、并发上限,还有一份得从别人 PDF 里建起来的知识库。这部分我们也在同一套硬件上做完。
会问候、会回答、会做手势的形象,本地驱动,语音与大模型都在同一台盒子上。用于前台、展厅、培训室。
你的手册、SOP、维修记录,切片、向量化、检索全部在设备本地。答案带出处页码,没有一份文件出厂。
离线语音识别,扛得住产线噪声。操作工戴着手套、眼前没有键盘,也能直接问。
本地语音播报,用于作业提示与报警。短、清楚,断网照常工作。
选型、量化、卡数规划,以及在你自己的提示词集上做性能验收 — 不是在我们准备好的样例上。
烧机、首线调试、北向闭环的采集策略,中英双语交接文档。
有一件事我们不装:单卡上 3B 和 7B 都跑得起来,但只有一个能通过真实提示词集、真实并发下的产线验收。在两者之间做选择是工程判断,而这正是这项服务有价值的部分。
两个主控共用一个壳体家族:拉丝铝型材机身,安装脚同时充当桌面支架和壁挂件,顶面只有一个 SMA 天线座。所有线都从同一个长边出来,所以盒子可以贴着面板装,只留正面可及。
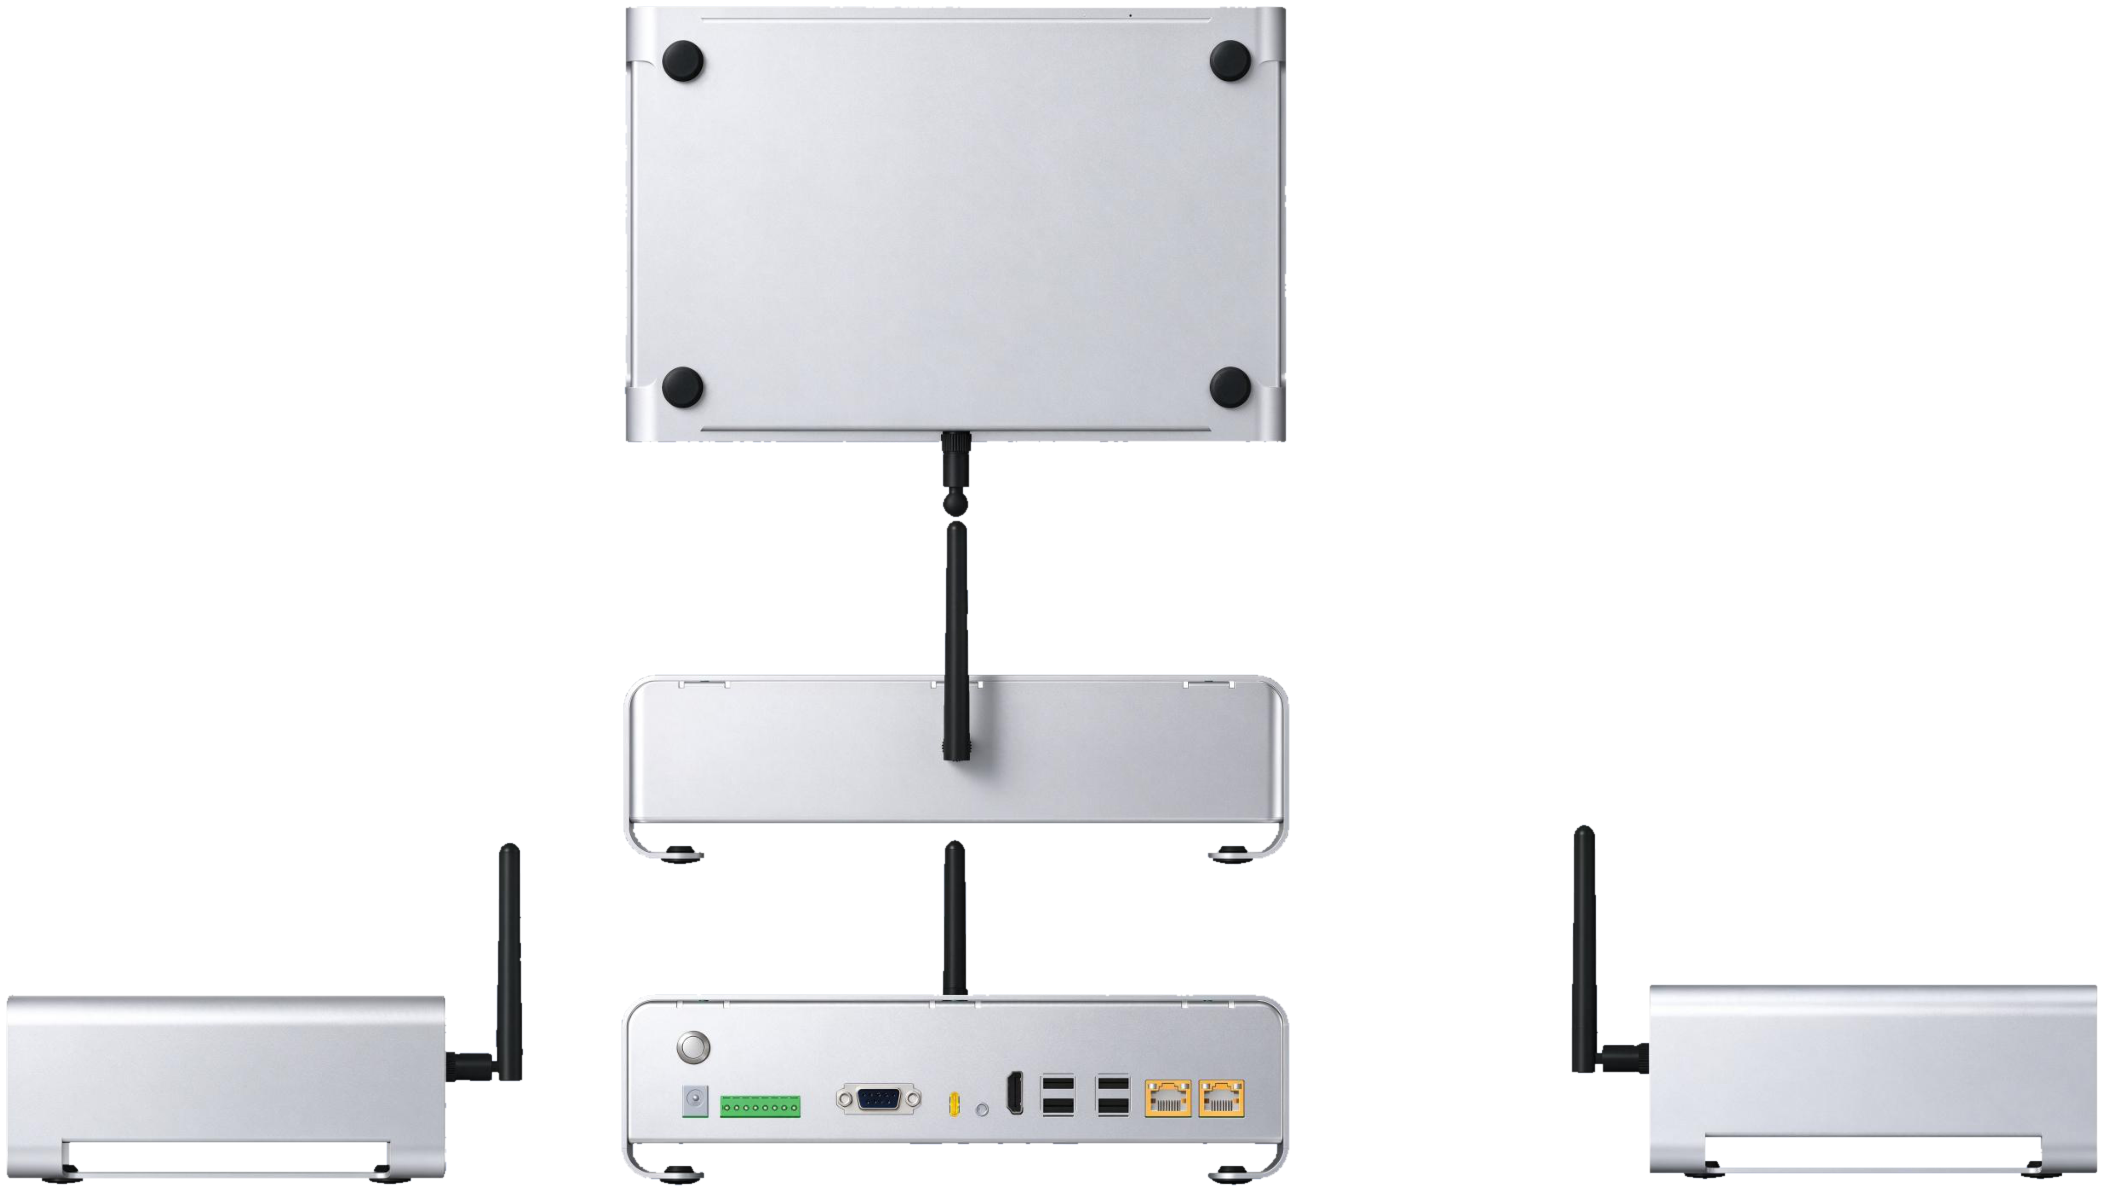
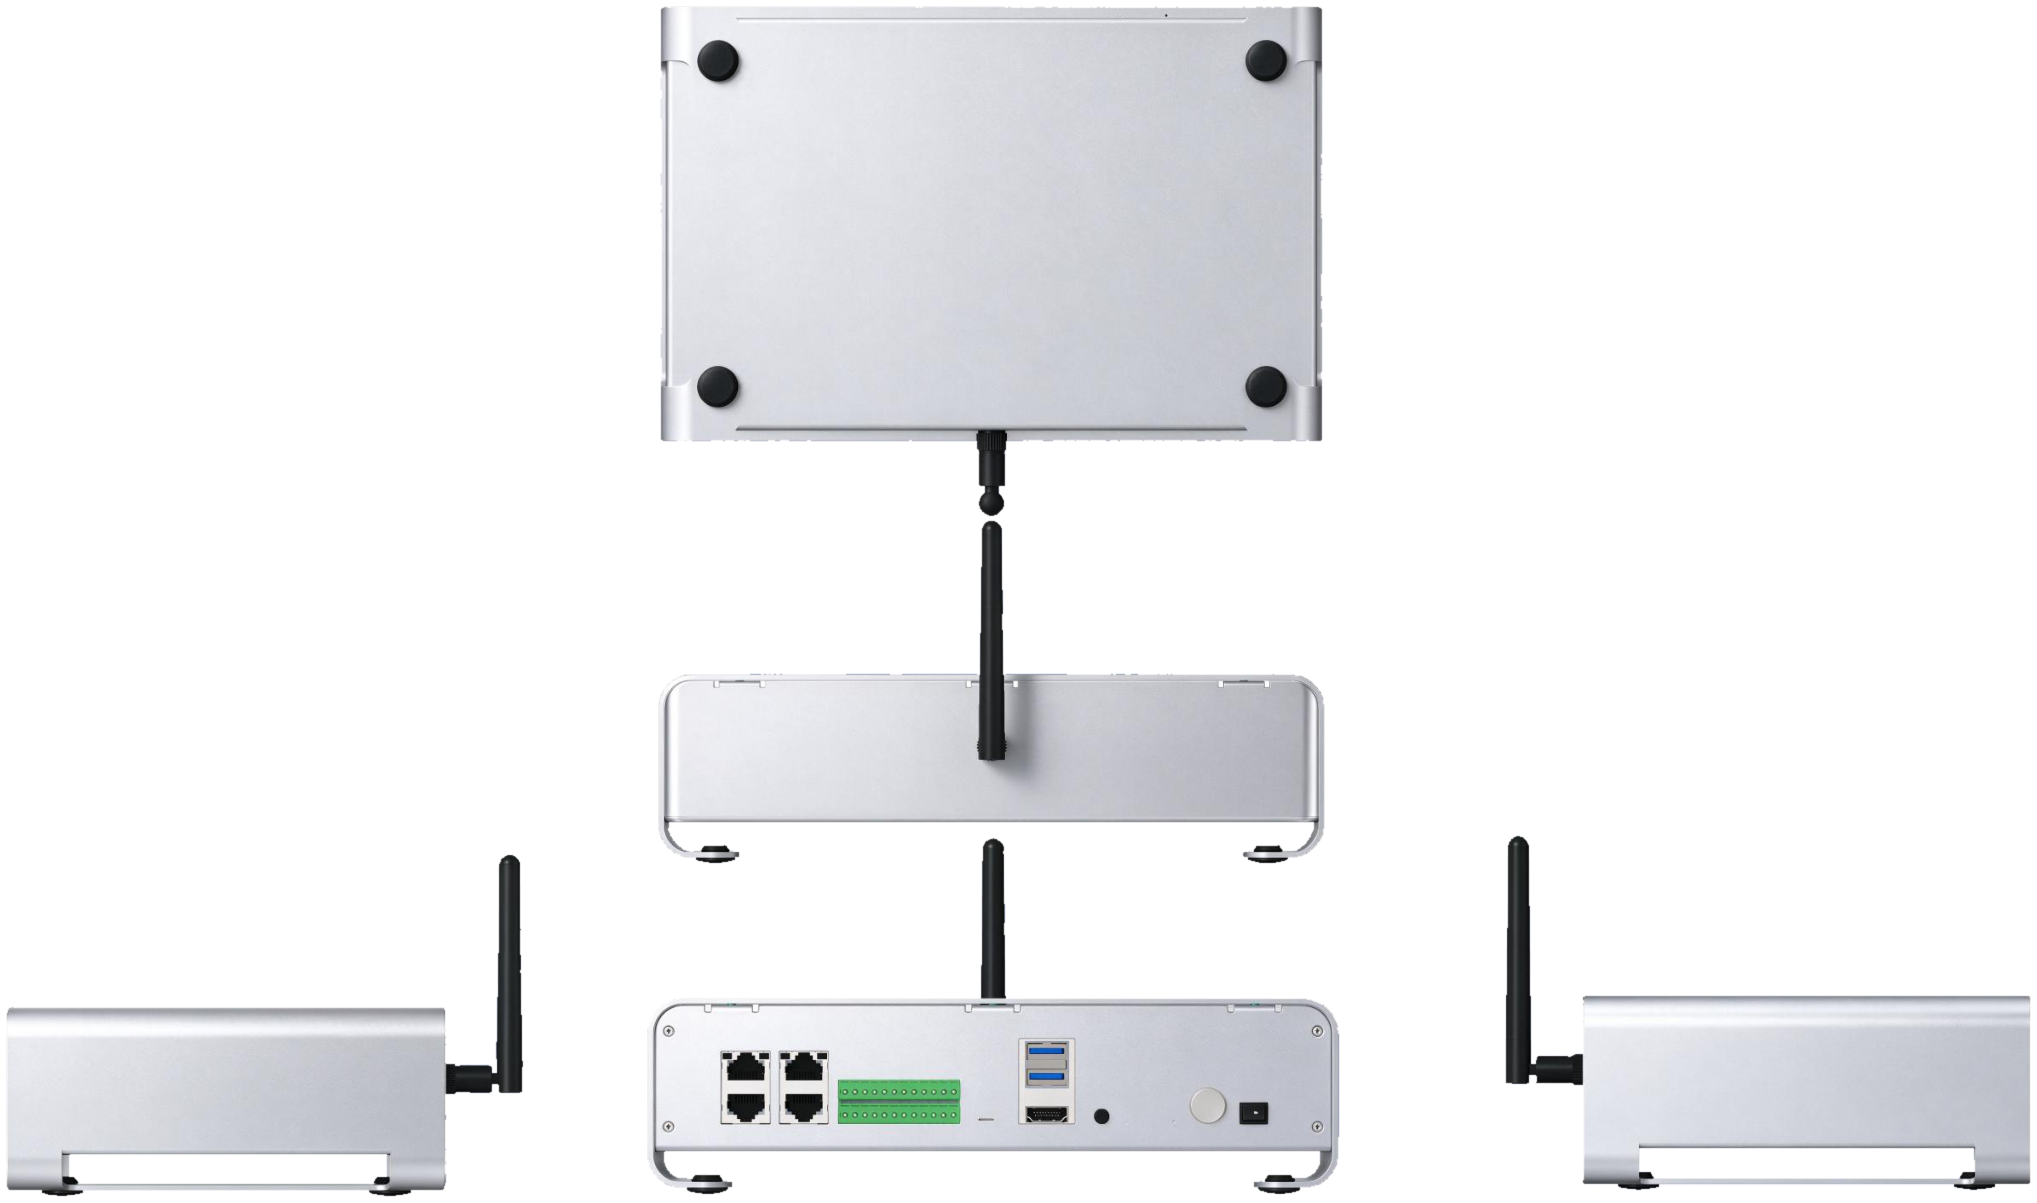
风道、风扇曲线和接口数量跟着配置走,因为四卡 27B 配置的散热量大约是单卡配置的两倍,风扇曲线必须按实装的那几张卡来标定。机械尺寸、防护等级与接口数量按项目配置确定,不按型号名确定 — 我们随报价一起给,而不是登一个只对某一种变体成立的字。
| 项目 | RK3576 配置 | RK3588 配置 |
|---|---|---|
| 主控处理器 | RK3576 — 4× Cortex-A72 + 4× Cortex-A53,最高 2.2GHz,6 TOPS INT8 NPU,8K30 解码,三路独立显示 | RK3588 — 4× Cortex-A76 + 4× Cortex-A55,最高 2.4GHz,6 TOPS INT8 NPU,8K60 解码,PCIe 3.0 ×4 可拆 1×4 / 2×2 / 4×1 |
| 算力卡 | 1 × RK1828 | 1 或 4 × RK1828,或 KA08 通用 GPU |
| 模型级别 | 3B — LLM / VLM / 稀疏 MoE | 单卡 3B,两卡 9B,四卡 27B |
| 算力卡形态 | M.2 Key B-M 或 SO-DIMM | M.2 Key B-M 或 SO-DIMM |
| 主机接口 | PCIe 2.0 ×1 或 USB 3.0 | PCIe 2.0 ×1、PCIe Switch,或 USB 3.0 HUB |
| 卡上内存 | 封装内 5GB 三维堆叠 DRAM | 每卡 5GB |
| 算力 | 20 TOPS INT8,支持 INT4/8/16、FP8/16、BF16 | 每卡 20 TOPS INT8;KA08 为 32 TOPS INT8 |
| 推理时主机 CPU | —(未公开实测) | 以 4×A76 满载计 2.4–2.6 % |
| 整机功耗,两卡 | — | 均值 30.5W,峰值 67W |
| 整机功耗,四卡 | — | 均值 57.8W,峰值 119W |
| 随箱服务 | 数字人、RAG、ASR、TTS、LLM、部署 | 同上,另含多卡模型分段 |
| KA08 供货 | — | 接受预定,1 月交期,10 台起 |
| 机械与接口 | 按项目配置确定 — 随订单报价,不登单一数字 | |
能,生态里也有单卡跑 7B、8B 的公开实测。我们对单卡报 3B,是因为这个容量在真实提示词集上还留得出上下文长度和并发的余量。上限和承诺是两个不同的数,我们宁可让人按承诺来评判。
可以。RK1828 有 M.2 Key B-M 模组(约 81×25mm)和 SO-DIMM 模组(约 69.6×45mm,NPU 主频更高)两种形态,都走 PCIe 2.1 x1 或 USB 3.0。腔体有余量、又想要更高 NPU 主频,就选 SO-DIMM。
实测在 TTFT 与 prefill 上差约 2 到 3 个百分点,解码上基本没有差别。延迟敏感的产线指定 PCIe;做样机用 USB 3.0,因为一个 HUB 带四张卡是系统最快跑起来的办法。
按你手上已有的软件选。模型从 PyTorch 经 RKNN 工具链来,就选 RK1828,卡数决定模型大小。有一套能跑、又搬不动的 CUDA 与 TensorRT 管线,就选 KA08 让它继续跑。我们会告诉你你的负载要哪一种 —— 包括答案是"你其实不需要这台盒子"的时候。
实测,来自瑞芯微 2026.08 的多卡级联方案文档:全部 TTFT、prefill 与 decode 数据,主机 CPU 与内存开销,以及整机功耗。测试条件是 RK3588 主机、RK1828 SO-DIMM 模组、W4A16 量化、4K 或 8K 输入、128 输出 token。功耗是整机口径,含主机、四组模组与算力卡散热风扇,不是单卡数字。
我们的产品定义,未做跑分:单卡 3B 的容量。两卡与四卡的容量沿用厂商公开方案;单卡这个数字是我们的产品定位,我们不附一个自己没跑过的成绩。
来自算力卡厂商公开口径:RPP-R8 的各项数字 — 32 TOPS INT8、16 TFLOPS、1024 ALU、24MB 片上共享存储、59.7GB/s、PCIe Gen3 ×4、80 × 22 mm 模块、CUDA 与 TensorRT 兼容、32 路 1080p 解码能力。
刻意不写:任何模型在我们自己硬件上的 tokens/秒 — 量产整机上没测过,把厂商的数字当成我们的来登,是最平常的那种谎。KA08 卡载内存容量。两个配置的机械尺寸、重量、防护等级与接口数量,这些随配置走。任何模型准确率或检测良率的数字。
刻意不用:一份标注为机密、由第三方提供的案例报告。它的数字在本页一处都没有出现,哪怕有些地方用了会好看。